Yapay zeka teknolojisi, özellikle üretken yapay zeka sistemleri, son yıllarda çeviri, konuşma tanıma ve metin üretimi gibi alanlarda olağanüstü bir hızla gelişti. Büyük dil modelleri, milyarlarca parametreyle eğitilerek insan dilini anlama ve üretme kapasitesinde dev adımlar attı.
Ancak bu teknolojik ilerleme, dünya üzerindeki tüm diller için eşit şekilde gerçekleşmedi. Uzmanlara göre, dünyada konuşulan binlerce düşük kaynaklı dil, yapay zeka çağının sunduğu olanaklardan yeterince yararlanamıyor.
Dijital uçurum derinleşiyor
Yapay zeka modellerinin eğitilmesinde büyük ölçekli veri setlerine ihtiyaç duyulması, İngilizce, Mandarin Çincesi, İspanyolca ve Arapça gibi yaygın dillerin sistemlerde daha güçlü temsil edilmesine yol açıyor. Buna karşılık, daha az konuşulan ve dijital ortamda sınırlı içeriğe sahip diller, yapay zeka destekli araçlarda yeterli performans sergileyemiyor.
Bu durum, söz konusu dilleri konuşan toplulukların dijital platformlardan, eğitim teknolojilerinden ve çeviri hizmetlerinden giderek daha fazla dışlanmasına neden oluyor. Araştırmacılar, bu eğilimin kültürel çeşitliliği tehdit ettiği ve dijital uçurumu daha da derinleştirdiği uyarısında bulunuyor.
Çözüm arayışları sürüyor
Dünya genelindeki akademik kuruluşlar ve teknoloji şirketleri, düşük kaynaklı diller için yapay zeka çözümleri geliştirmek amacıyla çeşitli projeler yürütüyor. Açık kaynak veri setlerinin oluşturulması, topluluk katılımlı veri toplama girişimleri ve çok dilli model çalışmaları, bu dillerin dijital dünyada varlık göstermesi için atılan önemli adımlar arasında gösteriliyor.
Yine de uzmanlar, yapay zekanın dil eşitliği konusunda kapsayıcı bir yaklaşımla geliştirilmesi gerektiğini vurgulayarak, aksi halde teknolojinin yalnızca belirli dilleri ve kültürleri güçlendirmeye devam edeceğine dikkat çekiyor.
 Akıllı telefonlar bizi dinliyor mu? Uzmanlar gerçek tehlikeyi açıkladı
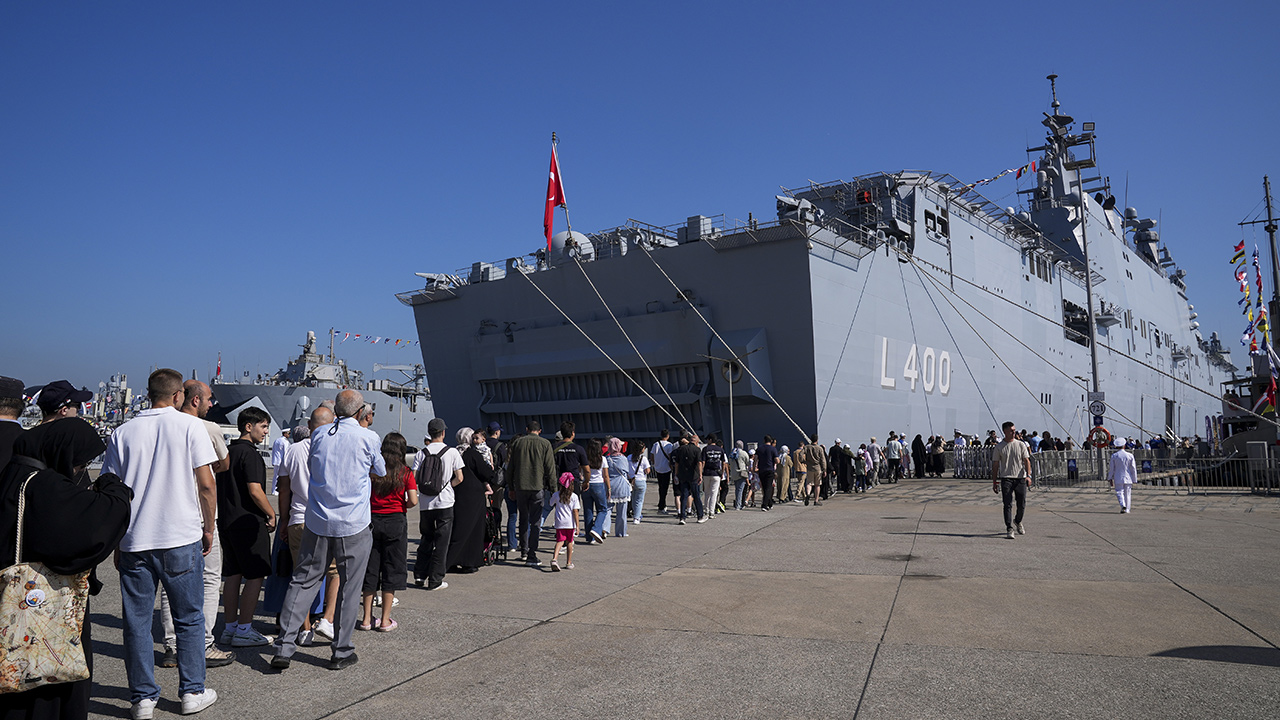 TEKNOFEST Mavi Vatan kapılarını açtı: 37 farklı donanma platformu ziyaretçilerle buluşuyor
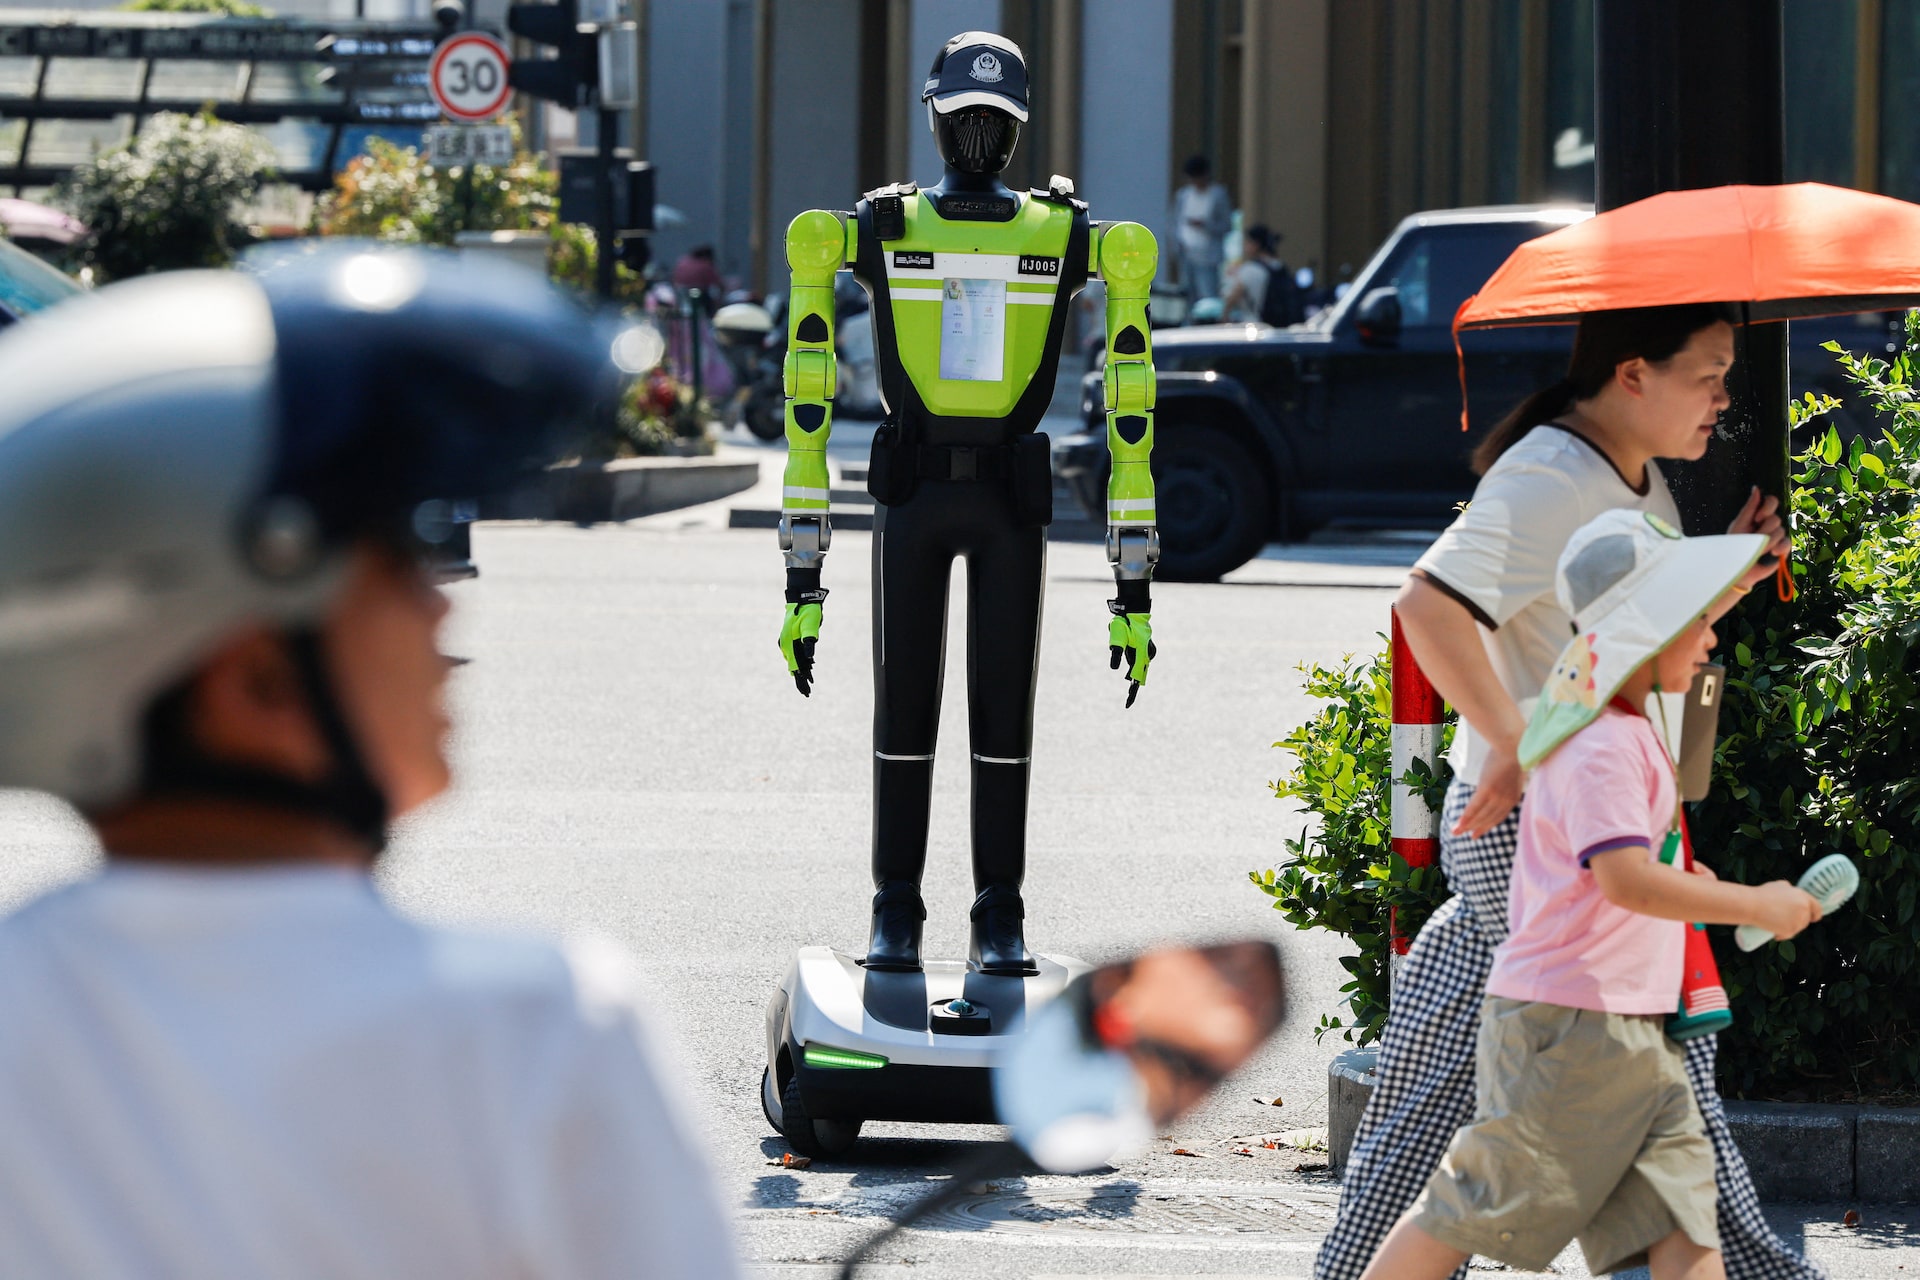 Çin'de robot trafik polisleri sahneye çıktı: Kask takmayan sürücüleri yapay zeka destekli makineler uyarıyor
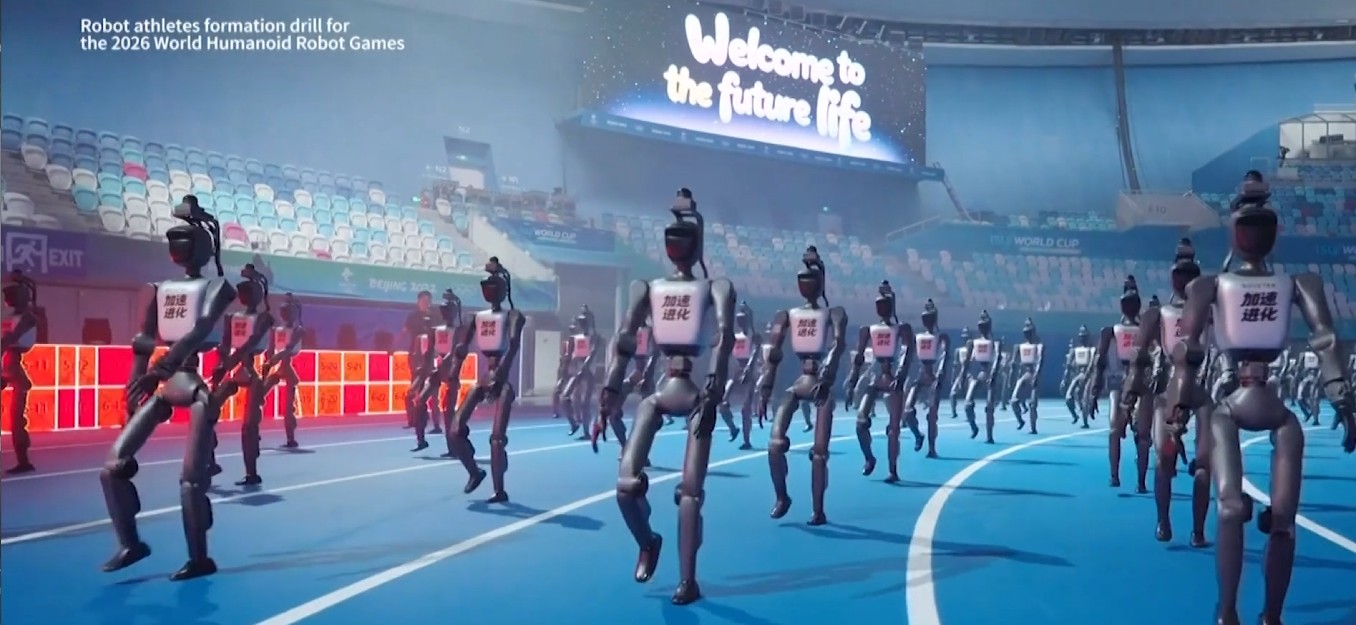 Pekin'de robotlar sahne aldı: Atlet, boksör ve barista bir arada
 NASA'nın 22 yıllık uzay gözlemevini kurtarma girişimi çöpe gitti: LINK uydusu yörünge operasyonunu tamamlayamadı
 Meta'nın eski mühendisinden mahkemede şok iddia: Çocuk güvenliği bilerek görmezden gelindi